2026년 10월 19일 오전 6:35 조회한 Artificial Analysis 공식 리더보드의 현재 모델·설정별 Intelligence Index 순서를 살펴봤습니다. 이번 기사의 1~10위는 원본 공개 순서를 유지했습니다.
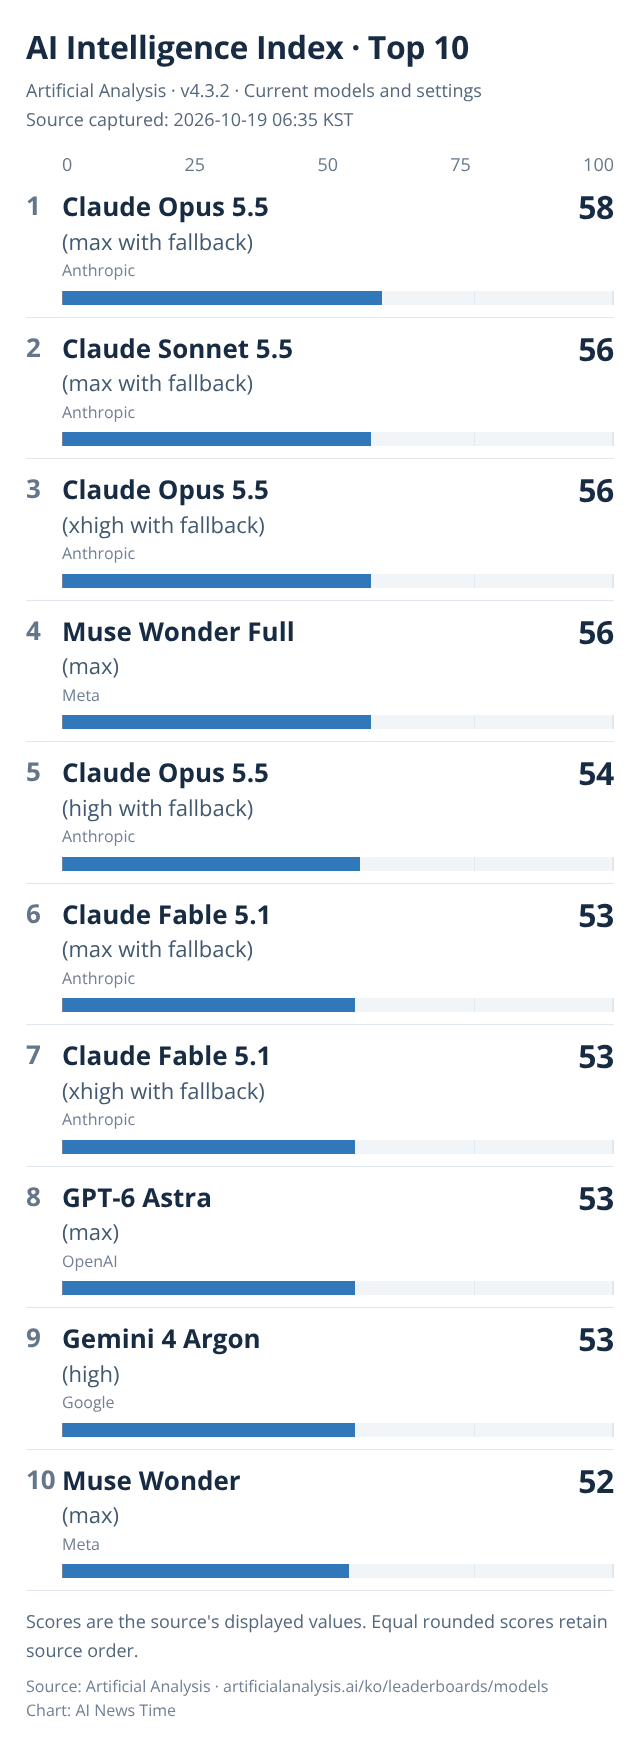
상위권에는 한 계열의 여러 추론 설정과 서로 다른 개발사의 모델이 함께 있습니다. 표시 점수만으로 고르기보다 작업당 비용, 답변이 시작되기까지의 대기, 시작 뒤 출력 속도를 나누어 살펴볼 필요가 있습니다.
지난주와의 비교
10월 3주차 기사에 사용한 2026년 10월 12일 오전 6:35 조회 기록과 비교했습니다. 같은 모델의 같은 추론 설정끼리 원본 순위와 표시 점수를 대조했습니다.
전주 비교 3개 항목은 순위와 표시 점수가 같습니다: Claude Opus 5.5 (max with fallback) (1위), Claude Sonnet 5.5 (max with fallback) (2위), Claude Opus 5.5 (xhigh with fallback) (3위).
전주 비교 Muse Wonder Full (max): 지난주 상위 10위 목록에 없었으며 이번 주 4위에 포함됐습니다. 실제 지난주 순위나 신제품 출시 여부는 이 두 목록만으로 알 수 없습니다.
전주 비교 Claude Opus 5.5 (high with fallback): 지난주 4위, 이번 주 5위를 기록하며 1계단 하락했습니다. 표시 점수는 같습니다.
전주 비교 Claude Fable 5.1 (max with fallback): 지난주 5위, 이번 주 6위를 기록하며 1계단 하락했습니다. 표시 점수는 같습니다.
전주 비교 Claude Fable 5.1 (xhigh with fallback): 지난주 6위, 이번 주 7위를 기록하며 1계단 하락했습니다. 표시 점수는 같습니다.
전주 비교 GPT-6 Astra (max): 지난주 7위, 이번 주 8위를 기록하며 1계단 하락했습니다. 표시 점수는 같습니다.
전주 비교 Gemini 4 Argon (high): 지난주 8위, 이번 주 9위를 기록하며 1계단 하락했습니다. 표시 점수는 같습니다.
전주 비교 Muse Wonder (max): 지난주 상위 10위 목록에 없었으며 이번 주 10위에 포함됐습니다. 실제 지난주 순위나 신제품 출시 여부는 이 두 목록만으로 알 수 없습니다.
상위 10위 제외 GPT-6 Astra (xhigh) (지난주 9위), Claude Sonnet 5.5 (xhigh with fallback) (지난주 10위)은 이번 주 상위 10위 목록에 포함되지 않았습니다. 이번 주의 정확한 순위는 이 기사에 수집한 상위 10위 자료로 확인할 수 없습니다.
비교 참고 반올림된 표시 점수가 같아도 원점수까지 같다는 뜻은 아닙니다. 순위나 표시 점수의 변화만으로 실제 업무 성능의 개선·악화를 단정할 수 없습니다.
1위 Claude Opus 5.5 (max with fallback) Anthropic
자료 인용 종합 지능 지수 표시 점수 58점, 지수 작업당 비용 5.98달러, 출력 속도 초당 97토큰, 첫 청크 대기 556.94초로 표시됐습니다.
AI뉴스타임 해설 이 설정은 높은 표시 점수와 빠른 출력 속도를 보이지만, 확인된 항목 가운데 첫 청크 대기가 가장 깁니다. 기다림을 감수할 만큼 높은 설정이 필요한지, 반복 사용 비용까지 고려해 실제 질문으로 확인해보는 편이 좋습니다.
2위 Claude Sonnet 5.5 (max with fallback) Anthropic
자료 인용 종합 지능 지수 표시 점수 56점, 지수 작업당 비용 5.46달러, 출력 속도 초당 140토큰, 첫 청크 대기 380.34초로 표시됐습니다.
AI뉴스타임 해설 출력 속도는 높은 편이지만 첫 청크 대기도 깁니다. 이번 관측에서는 출력 속도가 소폭 낮아지고 첫 청크 대기는 짧아졌습니다. 긴 답변을 기다리는 경우와 짧은 문답을 이어가는 경우를 나눠 체감 시간을 살펴볼 수 있습니다.
3위 Claude Opus 5.5 (xhigh with fallback) Anthropic
자료 인용 종합 지능 지수 표시 점수 56점, 지수 작업당 비용 3.46달러, 출력 속도 초당 86토큰, 첫 청크 대기 121.99초로 표시됐습니다.
AI뉴스타임 해설 같은 계열의 다른 설정보다 확인된 작업당 비용이 낮고 첫 청크 대기도 짧습니다. 이번 관측에서는 출력 속도가 높아지고 대기가 줄었습니다. 빠른 시작과 비용을 함께 따지는 사용자에게 비교 선택지가 될 수 있습니다.
4위 Muse Wonder Full (max) Meta
자료 인용 종합 지능 지수 표시 점수 56점로 표시됐습니다.
AI뉴스타임 해설 이번 관측에 새로 포함됐으며 비용과 속도, 첫 청크 대기 자료는 확인되지 않습니다. 따라서 표시 점수만으로 실제 사용의 경제성이나 기다림을 판단하기 어렵고, 해당 설정의 측정값이나 직접 사용 결과를 확인해야 합니다.
5위 Claude Opus 5.5 (high with fallback) Anthropic
자료 인용 종합 지능 지수 표시 점수 54점, 지수 작업당 비용 1.82달러, 출력 속도 초당 83토큰, 첫 청크 대기 47.53초로 표시됐습니다.
AI뉴스타임 해설 확인된 설정 가운데 작업당 비용이 낮고 첫 청크 대기도 짧은 편입니다. 다만 이번 관측에서는 첫 청크 대기가 길어졌고, 표시 점수만으로 비용 절감이 실제 과제에 충분한 결과로 이어지는지는 알 수 없습니다.
6위 Claude Fable 5.1 (max with fallback) Anthropic
자료 인용 종합 지능 지수 표시 점수 53점, 지수 작업당 비용 7.63달러, 출력 속도 초당 71토큰, 첫 청크 대기 173.57초로 표시됐습니다.
AI뉴스타임 해설 작업당 비용은 확인된 항목 중 높은 편이며 출력 속도도 낮은 쪽입니다. 이번 관측에서는 첫 청크 대기가 짧아졌습니다. 응답을 시작하기 전 기다림과 반복 사용 비용을 함께 따져 설정의 필요성을 확인할 수 있습니다.
7위 Claude Fable 5.1 (xhigh with fallback) Anthropic
자료 인용 종합 지능 지수 표시 점수 53점, 지수 작업당 비용 5.98달러, 출력 속도 초당 64토큰, 첫 청크 대기 77.73초로 표시됐습니다.
AI뉴스타임 해설 같은 계열의 다른 설정보다 비용이 높고 출력 속도는 낮은 편입니다. 이번 관측에서는 첫 청크 대기가 줄었습니다. 시작까지의 기다림이 중요하다면 변화가 참고가 되지만, 반복 사용 빈도에 따른 비용도 함께 고려해야 합니다.
8위 GPT-6 Astra (max) OpenAI
자료 인용 종합 지능 지수 표시 점수 53점, 지수 작업당 비용 3.26달러, 출력 속도 초당 65토큰, 첫 청크 대기 285.18초로 표시됐습니다.
AI뉴스타임 해설 작업당 비용은 중간 수준으로 확인되지만, 첫 청크 대기와 출력 속도는 긴 편입니다. 이번 관측에서는 출력 속도가 높아지고 첫 청크 대기는 짧아졌습니다. 기다림을 줄이고 싶은 사용자라면 실제 질문으로 체감 차이를 확인하는 것이 좋습니다.
9위 Gemini 4 Argon (high) Google
자료 인용 종합 지능 지수 표시 점수 53점, 지수 작업당 비용 1.99달러로 표시됐습니다.
AI뉴스타임 해설 작업당 비용은 비교적 낮게 확인됐지만 출력 속도와 첫 청크 대기 자료는 없습니다. 두 지표가 빠르거나 짧다고 판단할 근거는 부족하므로, 비용을 중시하더라도 응답을 기다리는 경험은 별도로 살펴야 합니다.
10위 Muse Wonder (max) Meta
자료 인용 종합 지능 지수 표시 점수 52점, 지수 작업당 비용 4.52달러, 출력 속도 초당 176토큰, 첫 청크 대기 35.99초로 표시됐습니다.
AI뉴스타임 해설 비용과 대기시간이 확인된 항목 중 출력 속도가 가장 빠르고 첫 청크 대기도 짧습니다. 다만 작업당 비용은 낮은 편으로만 볼 수 없으므로, 답변을 빠르게 받는 이점이 반복 사용 비용보다 중요한지 따져볼 수 있습니다.
순위를 읽을 때 함께 볼 조건
먼저 실제로 자주 묻는 질문을 준비해 답변이 시작되는 시점과 답변이 이어지는 속도를 따로 살펴보십시오. 그다음 비슷한 질문을 반복해 비용 부담을 가늠하고, 필요한 결과 수준을 충족하는지 비교하는 순서가 실용적입니다. 이 해설은 관측값을 바탕으로 한 편집부의 해석이며, 점수나 속도만으로 개인의 업무 결과를 미리 단정할 수는 없습니다.
평가 기준은 Artificial Analysis Intelligence Index v4.3.2입니다. 같은 모델의 서로 다른 추론 설정도 별도 항목입니다. 영어·텍스트 중심 평가이므로 한국어 능력이나 모든 실제 업무의 우열을 뜻하지 않습니다. 비용·속도·대기시간은 원문의 측정조건에 따른 값입니다.
출처: Artificial Analysis (artificialanalysis.ai). 이 기사의 해설·비평은 AI뉴스타임 편집부가 작성했으며 Artificial Analysis의 견해나 보증을 의미하지 않습니다. 원본 리더보드와 평가 방법은 아래 출처 링크에서 확인할 수 있습니다.