엔비디아는 표형 데이터의 분류와 회귀를 수행하는 기반 모델 Kumo Tabular를 허깅페이스에 공개했다고 밝혔다. 모델은 레이블이 있는 행을 문맥으로 받아 새 행의 레이블을 예측하며, 엔비디아에 따르면 별도의 학습·튜닝이나 특징 공학 없이 한 번의 순전파로 예측을 생성한다. 모델은 2,800만~2억1,500만 개 매개변수 규모의 세 가지 버전으로 제공되며, 상업적 이용이 가능한 OpenMDW-1.1 라이선스로 공개됐다.
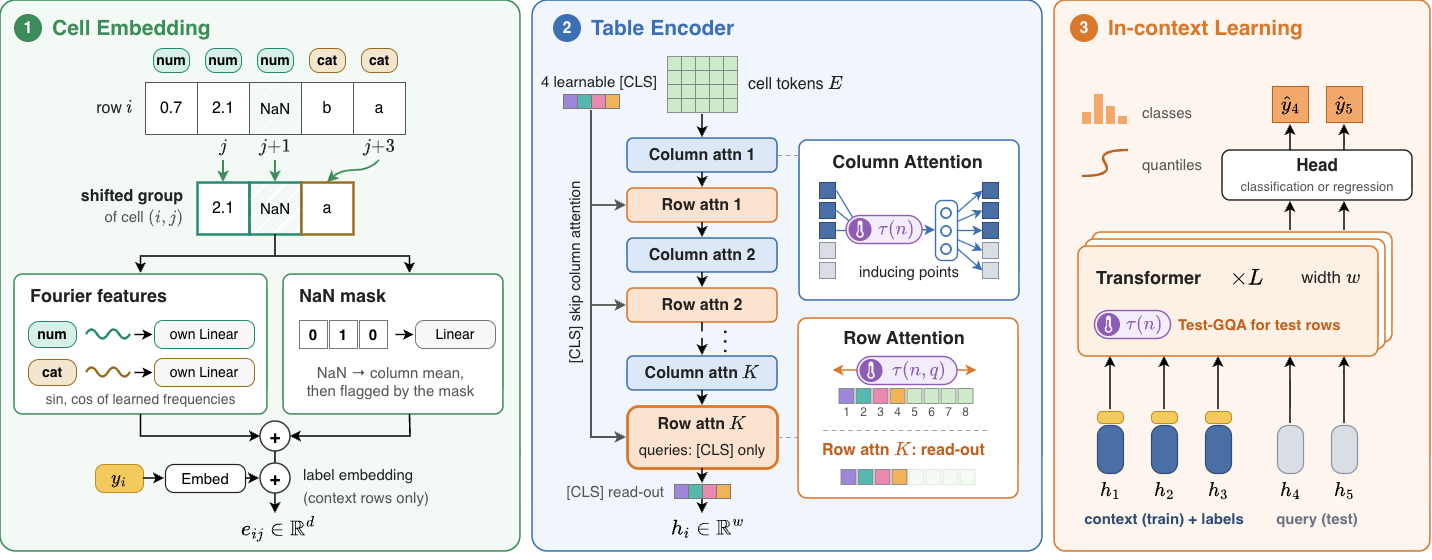
엔비디아는 Kumo Tabular가 인공적으로 생성한 표만으로 사전 학습됐다고 설명했다. 학습용 표는 구조적 인과 모델을 바탕으로 만들며, 결측치나 이상치, 다양한 범주의 열 등 실제 데이터의 불완전한 특성도 생성 과정에 포함했다고 밝혔다. 분류와 회귀는 별도 모델로 학습했고, 소·중·대형 모델은 각각 약 3,500만·7,100만·1억3,700만 개의 인공 표를 학습에 사용했다. 엔비디아는 학습 방법과 인공 데이터 생성기를 추후 공개할 예정이라고 덧붙였다.
성능 비교 결과는 엔비디아가 제시한 수치다. 회사 측은 기본 설정으로 평가한 TabArena에서 Kumo Tabular가 ELO 1950으로 종합 1위에 올랐고, BeyondArena에서도 ELO 1418과 개선 가능성 점수 7.78%로 1위를 기록했다고 밝혔다. TALENT에서는 분류 정확도·분류 로그 손실·회귀 RMSE 기준으로 종합 선두였으며, ScoringBench에서는 대형과 중형 모델이 평균 순위 1위와 2위를 차지했다고 설명했다. 이 결과는 해당 벤치마크 평가에 대한 엔비디아의 보고이며, 원문은 자체 데이터에서의 검증 필요성도 언급한다.
모델이 직접 처리하는 열은 수치형과 범주형이다. 텍스트·이미지·시간 정보는 내장 전처리 방식으로 특징으로 바꿀 수 있다고 엔비디아는 설명했다. 한 번의 순전파에서 다룰 수 있는 클래스는 최대 10개이며, 라이브러리가 오류 정정 출력 코드를 이용해 그보다 많은 클래스로 확장한다. 학습 범위를 크게 벗어난 표나 문맥 행과 예측 대상 행의 데이터 분포가 다를 때는 정확도가 떨어질 수 있어, 실제 사용 데이터에서 정확도와 보정 상태를 확인해야 한다고 밝혔다.