앤트로픽은 2026년 9월 29일 Z.ai의 AI 모델 GLM-5.3에 대한 보안 평가를 공개했습니다. GLM-5.3은 이날 새로 출시된 모델이 아닙니다. 미국 국립표준기술연구소 NIST에 따르면 모델은 8월 14일 공개됐고, 모델을 실행하는 데 쓰이는 가중치는 그로부터 약 2주 뒤 공개됐습니다.
앤트로픽은 이미 알려진 Chrome V8 취약점을 활용하는 시험에서 GLM-5.3이 410회 시도 중 50회 완전한 공격 코드를 만들었다고 보고했습니다. 비교 대상인 Claude Mythos Preview는 56회였습니다. V8은 크롬 등이 자바스크립트 프로그램을 실행할 때 사용하는 엔진입니다. 이 결과는 정해진 실험 문제의 성적이며, 실제 이용자가 공격당한 비율을 뜻하지 않습니다.
별도 시험에서 제시된 64~100%도 다른 의미입니다. 외부 시스템에 연결되지 않고 생성한 코드도 실행하지 않는 가상 환경에서, 시험 조건을 바꿨을 때 모델이 유해 요청에 응한 비율입니다. 요청을 훈련으로 위장한 조건과 안전장치를 변형한 모델을 사용하는 조건 등을 따로 시험했으며, 조건마다 50개 표본을 사용했습니다. 같은 가상 환경에서 직접 요청만 제시한 조건에서는 50개 표본 모두 거절했습니다. 따라서 이 수치를 ‘실제 해킹 성공률이 최대 100%’라고 설명하면 잘못된 전달이 됩니다.
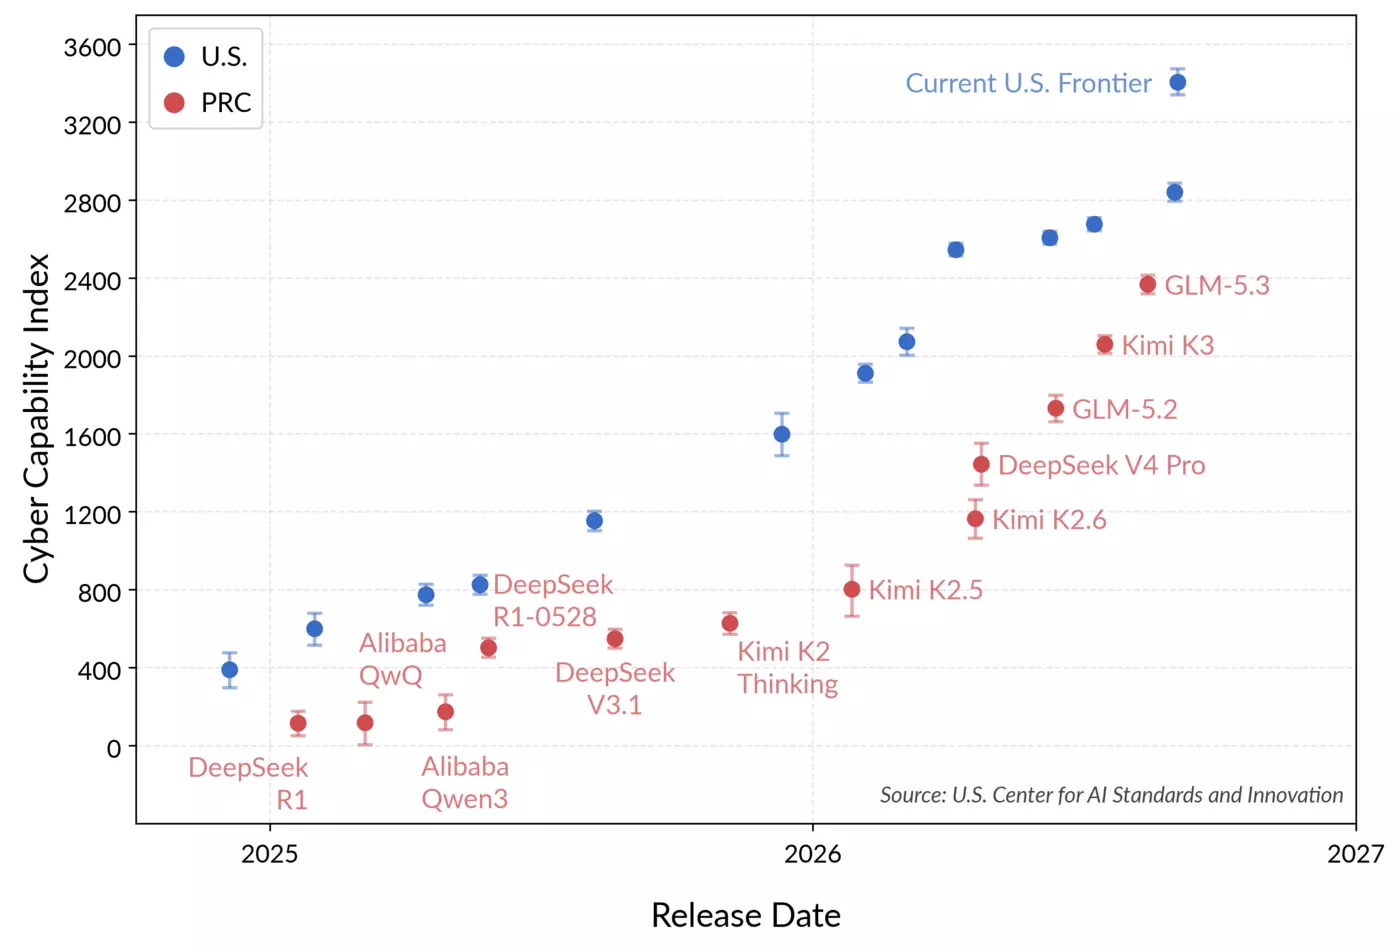
NIST 산하 AI 표준·혁신 센터 CAISI는 앞서 9월 17일 별도 평가를 발표했습니다. 당시 평가한 공개 가중치 모델 가운데 GLM-5.3의 사이버 능력이 가장 높다고 판단했지만, 종합 지표에서는 미국 최상위 모델보다 약 4개월 뒤처진다고 설명했습니다. 일부 미국 모델은 안전장치를 끈 상태로 시험했으므로, 일반 공개 서비스의 동작과 같은 조건이라고 보기는 어렵습니다. 함께 실은 그래프는 이 NIST 평가 자료입니다.
앤트로픽은 경쟁 모델을 개발하는 기업이므로 평가의 주체와 조건을 함께 읽어야 합니다. AI뉴스타임은 이번 논의에서 ‘능력’과 ‘실제로 허용되는 행동’을 구분하는 것이 중요하다고 봅니다. 강한 보안 분석 능력은 방어에도 활용될 수 있지만, 공개 방식과 접근 권한, 오용을 막는 장치를 어떻게 마련했는지까지 살펴야 이용 범위를 판단할 수 있습니다.